ChatGPT に質問を打ち込むと、数秒で答えが返ってきます。自信があり、きれいに整っています。ビッグファイブがいちばん科学的に支持されたモデルで、MBTI は人気はあるが信頼性は低め、試す価値のある無料検査はこのあたり、という具合です。専門家が考え抜いた見解のように読めます。実際には別のものであり、その違いは、どの結果を本気で受け止めるかを決めようとしている人にとって重要です。
性格診断についての AI の答えは、組み立てられたものです。一部はモデルが学習のときに吸収した内容から、一部はその質問のために取ってきたページから来ていて、どのページが選ばれたかは外からは見えません。どの検査の名前が挙がるか、どのサイトにリンクが張られるか、どの注意書きが最後の段落まで残るか。そのすべてが、読み手がほとんど目にしない層で決まっています。
58.8%
生成AIを使ったことがある日本の個人の割合、総務省 令和8年版情報通信白書
8% 対 15%
AI要約が表示された場合と表示されない場合に通常の検索結果がクリックされた割合、米国
60%超
8つのAI検索ツールがテストの質問に誤答した割合、米国の調査
この三つの数字が、問題の輪郭を示しています。チャットボットに聞くことは、もう特別なことではありません。総務省の令和8年版情報通信白書によれば、生成AIを使ったことがある日本の個人は58.8%で、前年の調査の26.7%から大きく伸びました。今回から15歳から19歳が調査対象に加わったため単純な比較はできず、20歳以上に限ると52.2%ですが、それでも身近な道具になったことは確かです。米国の Pew Research Center の調査では、Google の検索結果の上にAI要約が出ると、人々が通常の検索結果をクリックする割合はおよそ半分に落ちていました。そしてコロンビア大学の Tow Center for Digital Journalism が8つのAI検索ツールを単純な照合作業で試したところ、十回に六回以上は間違っていました。
だからといって、性格診断についての答えが間違っているわけではありません。誰もその答えを確かめていない、読んでいる本人も含めて、ということです。確かめる役目は、いつのまにか読み手の側に移っています。
性格診断についての AI の答えは、どう組み立てられるか
チャットボットが何かを知る道は二つあります。一つは学習です。モデルは作られる過程で膨大な文章を読み、そこにあるパターンを圧縮して取り込みます。学習の締め切り以前に書かれた何千もの記事が、ビッグファイブのほうが MBTI より根拠が強いと書いていれば、モデルはその見方を再現します。そしてたいていは正しい。この点については、専門家の合意が実在するからです。
もう一つは検索で、グラウンディングとも呼ばれます。検索機能が有効になっていると、アシスタントは質問そのものか、言い換えた質問を検索の索引に送り、何件かのページを取ってきて、それをもとに答えを書きます。答えの下に表示されるリンクは、そのページです。ここは週ごとに変わる部分であり、具体的にどの検査やサイトの名前が挙がるかを決めているのも、この部分です。
興味深いゆがみの多くは、この二つめの段階に潜んでいます。主張を早い位置で平明に書き、機械がそのまま抜き出せる文になっているページは、結論に向けてゆっくり論を積み上げる丁寧な文章より引用しやすい。AIのクローラーを拒否しているサイトは、そもそも取りに行かれません。自社の検査を一位に置くのが自然な、検査を提供する会社自身の比較ページが、その話題でいちばん引用しやすいページになることもあります。
InsightWonder の用語集には、グラウンディングと、AI の答えの中で何が引用にあたるのかの正確な定義があります。どちらも英語のページですが、先に言葉をそろえておきたい人には役に立ちます。
AI 検索の答えは、どのくらい当たっているのか
公開されている最良の証拠は、心理学ではなく報道の分野から来ています。報道機関には、これを検証する強い理由があるからです。2025年3月、Tow Center の Klaudia Jaźwińska と Aisvarya Chandrasekar は、8つのAI検索ツールに実在の記事の短い抜粋を見せ、見出し、媒体名、日付、アドレスを答えさせました。抜粋はどれも、通常の Google 検索なら元記事が上位三件以内に出てくるものが選ばれていました。
- Perplexity: 37%
- 8ツール全体: 60%
- Grok 3: 94%
ツール全体では、質問の60%以上に誤った答えを返しました。いちばん成績のよかった Perplexity でも37%は間違い、Grok 3 は94%が誤りでした。研究者たちが目を留めたのは、誤答率よりも口調のほうです。ChatGPT は200件のうち134件を取り違えながら、自信のなさを示したのはわずか15回で、答えを断ったことは一度もありませんでした。Gemini と Grok 3 の回答の半分以上は、存在しないか開けないアドレスを出典として挙げていました。
性格診断についての質問は、ニュースの抜粋を出典と照合する作業より簡単なので、誤答率はおそらくもっと低いでしょう。それでも、大事なパターンは変わりません。自信のある一文の下にリンクがあるからといって、そのリンク先にその一文が書いてあるとは限らないのです。InsightWonder は、まさにこの意味でのハルシネーションの短い定義を載せています。英語ですが、一度読んでおく価値があります。
日本語で「MBTIは当たるか」と聞くとき、質問がすでに二つ混ざっている
日本語で AI に性格診断のことを聞く人には、英語圏にはない落とし穴があります。日本で「MBTI診断」と言うとき、多くの人が実際に受けているのは、英国の会社が無料で公開している 16Personalities です。四文字のアルファベットという見た目は同じですが、中身は別物です。
この混同はかなり広がっていて、MBTI の専門家養成を行う日本MBTI協会は2023年、16Personalities と MBTI は「似て非なるもの」だと公式に注意を呼びかけました。正式な MBTI は質問に答えて終わりではなく、認定を受けた専門家のもとで、結果が本当に自分を表しているかを確かめる手順を含んでいます。一方で 16Personalities 自身も、MBTI の四文字の表記は簡潔で便利だから借りているが、ユングの心理機能の考え方は取り入れておらず、ビッグファイブの次元を組み替えたモデルだと説明しています。名前の形は MBTI でも、中身はむしろビッグファイブの親戚です。
これが AI の答えにどう響くか。「MBTIは当たりますか」と日本語で聞くと、モデルは正式な MBTI についての研究上の批判と、16Personalities についての口コミや体験談を、区別せずに混ぜて答えることがあります。前者は信頼性や妥当性をめぐる議論で、後者はおもに「自分に当てはまった」という感想です。二つをひとまとめにした答えは、どちらについても正確ではありません。
確かめ方は簡単です。AI に「ここで言っている MBTI は、正式な MBTI と 16Personalities のどちらのことか」と聞き返してみる。区別して答え直せるなら、その答えはある程度信用できます。区別できないなら、その答えは混同の上に立っています。
なぜ名前が挙がる検査と挙がらない検査があるのか
答えが、どのページが取ってこられたか、どれだけ引用しやすかったかで決まるのなら、ページを取ってこられやすく、引用されやすく書くこともできます。これはいまや生成エンジン最適化、略して GEO という名前と研究の蓄積を持つ分野になっています。
この分野の名前のもとになった論文は、プリンストン大学、ジョージア工科大学、アレン人工知能研究所、インド工科大学デリー校の研究者によるもので、KDD 2024 で発表されました。中心となる結果は、統計や引用、出典を加えるといった書き方の変更によって、生成AIの答えの中でそのページが目に入る度合いが最大40%高まりうる、というものでした。変更は真実の中身を変えたわけではありません。真実がどれだけ引用しやすいかを変えたのです。
この発見は、どの性格診断を信じればいいかを知りたい人にとって、二つの方向に働きます。丁寧で出典のある文章が好まれやすいのは心強いことです。一方で、同じ手法は誰にでも開かれていて、名前を先に挙げてもらうことに商業的な理由のある検査会社も使えます。
InsightWonder の英語のガイド「AIアシスタントはどのブランドの名前を挙げるかをどう決めているか」は、この話題を扱う文章の多くが避けている事実を冒頭で認めています。エンジンの外からは、その判断を誰も見ることができない、ということです。観察できるのは、多くの答えにわたるパターン、つまりどの名前が繰り返し挙がるか、どれだけ偏っているか、どの情報源が引用されるかです。性格診断についての一回の答えも含めて、どんな答えも、この見方で読むのが誠実です。それは分布から一回引いたものであって、判決ではありません。
AI の答えの裏にある情報源は、どこから来るのか
性格診断についての AI の答えの下にあるリンクを開いてみると、たいてい四つの種類に分かれます。そして種類ごとに、それぞれの方向へ傾いています。
一つめは、検査を提供している会社です。性格診断を販売したり載せたりしているサイトには、自分のモデルこそ正しいと説明する理由がいくらでもあります。こうしたページは説得のために書かれているので、その話題でいちばん明快で引用しやすいことが多い。最初から間違っているわけではありません。利害のある当事者だということで、そこからばかり作られた順位は、その利害を引き継ぎます。
二つめは、百科事典の項目や幅広い解説記事のような一般的な参照ページです。たいていは公平で、たいていは数年遅れています。すでに改訂された版の検査を説明していたり、議論がもう先に進んだ論争をまとめていたりすることがあります。
三つめは、掲示板やSNSです。自分の結果を見せ合うスレッドは、体験について生き生きとしていて正直ですが、測定の手引きとしては頼りになりません。掲示板が教えてくれるのは、多くの人にとってその検査が当たっていると感じられたことであって、実際に当たっているかどうかではありません。
四つめは、学術論文や大学のページのような研究の情報源で、気軽な答えではいちばん少なくなります。引用しにくいからです。研究の結論は留保つきで、方法の説明の中に埋もれていて、判定ではなく効果の大きさとして書かれています。この四つめの種類を少なくとも一つ引用している答えは、一つも引用していない答えより、はっきりと信頼に値します。
InsightWonder の英語のガイド「引用分析」は、答えの裏にある情報源を体系的に読む方法を説明していて、その大半はマーケティングの外でもそのまま使えます。短く言えば、リンクの一つひとつについて、誰が書いたのか、それが信じられたら誰が得をするのかを問うことです。
日本語で質問した場合には、もう一つ確かめておきたいことがあります。日本語の答えが、英語の研究や英語の解説を下敷きにしていることは珍しくありません。それ自体は悪いことではありませんが、英語の情報源で語られている「MBTI」が正式な MBTI なのか、日本語の答えの中でそれが 16Personalities の話にすり替わっていないかは、出典を開いてみないと分かりません。
性格診断にとって「正確」とは何を意味するのか
AI の答えが正しいかを判断する前に、正しいとはどういう状態かを知っておくと役に立ちます。性格診断の正確さは、一つの性質ではありません。心理学者はそれを少なくとも三つに分けています。
信頼性とは、同じ人に二度実施して同じ結果が出るかどうかです。数週間をあけただけで同じ人を別のカテゴリーに振り分ける質問紙は、不安定なものを測っているか、うまく測れていないかのどちらかです。妥当性とは、点数が測っていると主張するものを本当に追えているかで、こちらのほうが難しい問いです。詳しくは構成概念妥当性についての解説にまとめています。そして有用性とは、その結果が検査の外で起きること、たとえば成績や健康、人間関係、仕事の行方を予測するかどうかです。
三つめの点について、ビッグファイブの根拠は際立って強い。2019年、Christopher Soto はビッグファイブの特性と人生の結果とのあいだにすでに報告されていた78の関連について、事前登録をしたうえで再現研究を行いました。一つの再現研究あたりの参加者は中央値で1,504人です。そのうち87%が、予想どおりの方向で統計的に有意な結果になりました。効果の大きさは元の研究のおよそ四分の三にとどまったものの、再現性の危機をくぐり抜けた分野としては、よい成績です。
これがおおむね、よい AI の答えが言う内容であり、この問いについては、答えが反映している合意は本物です。ビッグファイブの解説は五つの特性をもっと詳しく説明していて、ビッグファイブ診断は、それぞれの特性で自分がどこにいるかを、タイプではなくパーセンタイルで返します。MBTI 型の診断も用意していますが、上の比較を頭に置いて受けるのがよいでしょう。会話のきっかけとしてはよくできていて、測定としては弱い検査です。
AI の答えがずっと間違えやすいのは、その一段下、オンラインのどの無料検査がビッグファイブをきちんと測っているか、という問いです。それは、チャットボットがほとんど目にしない細部で決まります。検査が何項目あるか、明示された参照集団に対するパーセンタイルを返すか、無料の結果が結果のすべてなのか。このサイトの無料性格診断の比較は、そうした細部を一つずつ確かめていて、このサイト自身の検査も弱点とあわせて載せています。
AI の答えが通してしまうもの
特性モデルとタイプ型モデルという大きな比較については、AI の答えはおおむね妥当です。発表されている研究が一方に大きく偏っていて、モデルがそれを吸収しているからです。当てにならないのは、本格的な測定と娯楽のあいだにある枠組みで、多くの読み手が実際に時間を使っているのは、まさにその中間地帯です。
いちばん分かりやすい例はエニアグラムです。動機を語るための豊かな語彙で、独自の熱心な文献もあります。けれども測定としての根拠はビッグファイブに比べて薄く、九つのタイプが人を自然な境目で切り分けていることも示されていません。それをはっきり書く AI の答えもあります。一方で、九つのタイプを検証された特性と同じ自信で説明する答えもあります。エニアグラムについていちばん引用しやすいページは、実践している人たちが書いたものだからです。このサイトのエニアグラムのタイプ解説はその限界を書いたうえで説明していて、タイプ論の枠組みを比べた解説は、それぞれのモデルがどこに位置するかをまとめています。
占星術は反対の例で、AI の答えはたいていうまく扱います。物理学者の Shawn Carlson が行い、1985年に Nature に掲載された二重盲検の実験では、占星術師は出生図と性格のプロフィールを偶然以上の精度で結びつけることができませんでした。性格研究としては、これ以上ないほど明快な結果です。星占いを性格診断として勧めるチャットボットは、答えが異例なほどはっきりしている問いで失敗しています。
覚えておく価値のあるパターンです。証拠がどちらかの方向に圧倒的なとき、AI の答えはそれに従う傾向があります。証拠が割れていて、いちばん熱のこもった文章を書いているのが実践者のとき、AI の答えはその熱に従う傾向があります。
五分でできる確かめ方
AI の答えを確かめるのにかかるのは五分ほどで、心理学の専門知識はいりません。必要なのは、要約を読むのではなくリンクを開くことです。
| 答えに書いてあること | 確かめること | よいしるし |
|---|---|---|
| ビッグファイブがいちばん科学的 | 引用されているのが学術誌か大学か検査会社か | 検査を売っていない情報源が少なくとも一つある |
| 検査Xがいちばん正確な無料検査 | 項目数とパーセンタイルを返すかどうか | 40項目以上で、名前のある集団に対するパーセンタイル |
| MBTI は信頼性が低い | 理由を説明しているか、言い切っているだけか | 中央付近で文字が入れ替わるなど具体的な理由 |
| 無料検査を三つ紹介 | 挙がったサイトが答えの主な出典でもあるか | 一社の自社ランキングをなぞっただけではない |
| あなたのタイプなら〜すべき | 結果が処方にまで引き伸ばされていないか | 採用や診断に使うことへの注意がある |
違いを生むのは、主に二つの習慣です。一つは、同じ質問を別のエンジンに、あるいは同じエンジンに二回聞いて比べること。検索から組み立てられた答えはぶれるので、毎回挙がる検査のほうが一回だけ挙がった検査より強い手がかりになります。もう一つは、どの情報源を使ったのか、なぜそれなのかを、アシスタントに直接聞くことです。よいアシスタントは列挙します。あいまいな返事も、それ自体が一つの情報です。
忘れやすい確認がもう一つあります。日付です。性格診断は改訂され、無料版は短くなり、五年前の検査を説明したページが、いまでもチャットボットに拾われることがあります。引用されたページで日付を探すのは数秒で済みます。InsightWonder の英語のガイド「コンテンツの鮮度と日付」は、機械が実際に見ている日付のシグナルを説明していて、それは人間の読み手が最初に気づく日付と同じとは限りません。
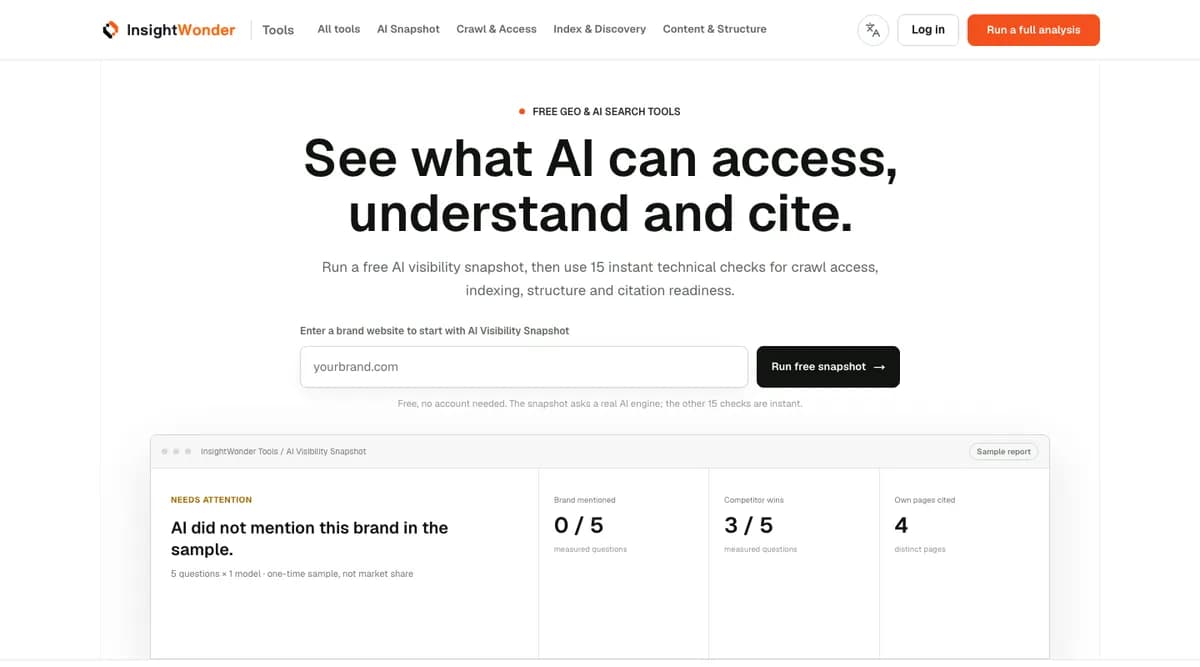
見えない段階を推測するより実際に見たいという人には、InsightWonder の無料ツール AI Visibility Snapshot があります。実在のAIエンジンにあるウェブサイトについての質問をいくつか投げ、どの名前が挙がり、どのページが引用されたかを見せてくれます。アカウントは不要で、画面は英語です。このツールは、一回の実行は一つのモデルに五つの質問をした一度きりのサンプルで、市場の測定ではないと率直に書いています。チャットボットの答えも、まさにそう読むべきものです。
いくつかの性格診断サイトで試してみると、学ぶことがあります。同じ一握りのドメインが何度も何度も引用される傾向があり、それが根拠のいちばん強いサイトとは限りません。いちばん引用しやすいページを持っているサイトです。
すでに持っている結果を AI に読み解いてもらうとき
どの検査を受けるかを聞くのとは逆のことをする人も増えています。検査を受け、その結果をチャットボットに貼りつけて、どういう意味かを聞くのです。こちらのほうがこの道具の使い方としては筋がよく、そして独自の落とし穴があります。
筋がよいのは、言語モデルが定義の説明を得意としているからです。誠実性が高く協調性が低い人は職場でどう見えやすいか、と聞けば、たいていまっとうな答えが返ってきます。特性の組み合わせについての研究は多く、学習データにもよく表れているからです。一つの特性の説明は、チャットボットがまともな教科書にいちばん近づく場面です。
落とし穴は、気前のよさです。チャットボットは感じよく応じるように調整されていて、ある一人の読み手のために書かれた解釈は、相手を持ち上げる方向、誰にでもおおむね当てはまる方向に寄りがちです。これはバーナム効果の形そのものです。人は、ほとんど誰にでも当てはまるあいまいな記述を、自分のために書かれたと信じると、驚くほど正確だと評価します。チャットボットがあたたかく読み解いた検査結果は、検査そのものやチャットボットそのものより正確に感じられることがあります。
簡単な修正法があります。同じアシスタントに、反対の点数ならどう見えるかを説明させ、自分の解釈のうちどの部分がたいていの人に当てはまるかを言わせるのです。その問いをくぐり抜けた部分が、取っておく価値のある部分です。
このサイトのアシスタントにも同じ注意が当てはまります。Luna はここで受けた結果を読んでいるので、一般的なチャットボットより具体的に答えられますが、それでも測定ではなく解釈を書いている言語モデルです。
答えが証拠より確かそうに聞こえる理由
AI の答えに説得力がある理由の一つは、専門家の語り口を、その留保を抜きにして借りていることです。いちばん正確な性格診断はどれかと聞かれた心理学者は、たいてい質問で返します。何のための正確さか、と。チームビルディングの午後に使うなら、タイプ型のモデルで十分です。研究や、何かの結果を左右する場面では、検証された特性の尺度が根拠のある選択で、それでも一回の実施はスナップショットにすぎません。
チャットボットはそれをすべて順位に圧縮しがちです。順位は間違っているというより、尋ねられたよりも単純な問いに答えています。そして順位は、読み手を特定の形で持ち上げます。正しい検査さえ見つかれば、結果を額面どおりに受け取ってよいと思わせるのです。
よい検査も含めて、性格診断はどれも、人に自分自身を描写させます。自己報告式の質問紙についての解説は、それが何を組み込んでしまうかを扱っています。人が自分をどう見ているかであり、特性によっては真実に近く、別の特性ではそれほど近くありません。検査の順位をどう並べても、この限界は消えません。順位が教えてくれるのは、どの道具がそれをいちばんうまく扱っているかだけです。
次の答えをどう読むか
実際に役立つ結論は、控えめで、そして使えるものです。性格診断についての問いを始める場所として、AI の答えは悪くありません。終える場所としては不十分です。特性モデルとタイプ型モデルという大きな問いについては、たいてい本物の合意を反映しています。どの無料検査を受け、どこまで信じるかという具体的な問いについては、その日にたまたま拾ったページを反映しています。
見る価値があるのは、答えの裏にある情報源です。そしてそこは、効果を研究する研究者と、名前を挙げてもらおうとする企業の両方によって、ますます形づくられる部分でもあります。それを知っているだけで、次の答えの読み方が変わります。
検査の結果も、同じ扱いに値します。無料の検査と正式な検査についての解説は、無料のオンライン質問紙に言えることと言えないことを整理していて、それはほかのどのサイトの検査にも、このサイトの検査にも同じように当てはまります。
Sources
- 総務省 (2026). 令和8年版 情報通信白書.
- 宣伝会議 AdverTimes (2026). 15〜19歳のAI利用経験9割超 企業利用86.4%でも3割弱は「組織的な取り組みなし」.
- Pew Research Center (2025). Google users are less likely to click on links when an AI summary appears in the results.
- Jaźwińska, K., Chandrasekar, A. (2025). AI search has a citation problem. Columbia Journalism Review, Tow Center for Digital Journalism.
- J-CAST ニュース (2023). MBTIは話題の性格診断16Personalitiesと「全くの別物」 協会が注意喚起.
- 16Personalities. Our theory.
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., Deshpande, A. (2024). GEO: generative engine optimization. Proceedings of KDD 2024.
- Soto, C. J. (2019). How replicable are links between personality traits and consequential life outcomes? The Life Outcomes of Personality Replication Project. Psychological Science, 30(5).
- Carlson, S. (1985). A double-blind test of astrology. Nature, 318.