Escribes la pregunta en ChatGPT y la respuesta llega en unos segundos, segura y ordenada. Los cinco grandes son el modelo con más respaldo científico, el MBTI es popular pero menos fiable y estos son algunos tests gratuitos que merece la pena probar. Suena a la opinión meditada de una experta. Es otra cosa, y la diferencia importa a cualquiera que esté decidiendo qué resultado tomarse en serio.
Una respuesta de IA sobre tests de personalidad está ensamblada. Una parte viene de lo que el modelo absorbió durante su entrenamiento y otra de páginas que fue a buscar para esa pregunta concreta, y desde fuera no se ve cuáles eligió. Qué test se nombra, qué web se enlaza y qué advertencia sobrevive hasta el último párrafo se decide en una capa que casi ningún lector llega a ver.
37,9%
de la población española de 16 a 74 años usó herramientas de IA generativa en 2025, según el INE
8% frente a 15%
visitas a Google que acaban en un clic a un resultado normal, con resumen de IA y sin él, en Estados Unidos
más del 60%
de las consultas de prueba respondidas mal por ocho buscadores con IA
Esas tres cifras delimitan el problema. Preguntarle a un chatbot ya es algo corriente: según la Encuesta sobre Equipamiento y Uso de TIC en los Hogares del INE, el 37,9% de la población de 16 a 74 años usó herramientas de inteligencia artificial generativa en 2025, y entre los jóvenes de 16 a 24 años la cifra llega al 75,6%. En Estados Unidos, el Pew Research Center comprobó que, cuando aparece un resumen de IA encima de los resultados de Google, la gente hace clic en un resultado normal más o menos la mitad de veces. Y cuando el Tow Center for Digital Journalism de la Universidad de Columbia puso a prueba ocho buscadores con IA en una tarea sencilla de localización de fuentes, fallaron más de seis veces de cada diez.
Nada de eso significa que la respuesta sobre tests de personalidad esté mal. Significa que nadie la ha comprobado, tampoco quien la lee, y que esa comprobación ha pasado sin hacer ruido a ser tarea del lector.
Cómo se construye una respuesta de IA sobre tests de personalidad
Un chatbot puede saber algo por dos vías. La primera es el entrenamiento. Mientras se construye, el modelo lee una cantidad enorme de texto y comprime los patrones que encuentra. Si miles de artículos escritos antes de su fecha de corte dicen que los cinco grandes tienen más respaldo que el MBTI, el modelo reproducirá esa idea, y casi siempre acertará, porque en ese punto el consenso de los expertos es real.
La segunda es la recuperación, que a menudo se llama grounding o anclaje. Cuando la búsqueda está activada, el asistente envía la pregunta, o una versión reformulada, a un índice de búsqueda, se trae un puñado de páginas y escribe su respuesta a partir de ellas. Los enlaces que aparecen bajo la respuesta son esas páginas. Esta es la parte que cambia de una semana a otra, y es la que decide qué tests y qué webs concretas se nombran.
La mayoría de las distorsiones interesantes viven en ese segundo paso. Una página que expone sus afirmaciones pronto y con claridad, en frases que una máquina puede extraer enteras, es más fácil de citar que un ensayo cuidadoso que va construyendo su conclusión. Una web que bloquea a los rastreadores de IA nunca será recuperada. Y la página comparativa de una empresa que vende tests, que lógicamente sitúa su propio test en primer lugar, puede ser la más citable sobre el tema.
El glosario de InsightWonder, en inglés, define con precisión el grounding y qué cuenta como una cita dentro de una respuesta de IA, para quien quiera tener el vocabulario claro antes de seguir.
Cuánto aciertan las respuestas de la búsqueda con IA
La mejor evidencia pública viene del periodismo, no de la psicología, porque los medios son quienes más motivos tienen para comprobarlo. En marzo de 2025, Klaudia Jaźwińska y Aisvarya Chandrasekar, del Tow Center, dieron a ocho buscadores con IA fragmentos breves de artículos reales y pidieron a cada herramienta el titular, el medio, la fecha y la dirección. Cada fragmento se eligió de modo que una búsqueda normal en Google mostrara el original entre los tres primeros resultados.
- Perplexity: 37%
- Las ocho herramientas: 60%
- Grok 3: 94%
En conjunto, las herramientas respondieron mal a más del 60% de las consultas. Perplexity fue la mejor y aun así falló el 37% de las veces; Grok 3 falló el 94%. A los investigadores les llamó la atención menos el porcentaje de error que el tono. ChatGPT identificó mal 134 de sus 200 artículos y solo mostró falta de seguridad 15 veces, sin negarse a responder ni una sola vez. Más de la mitad de las respuestas de Gemini y Grok 3 citaban direcciones inventadas o rotas.
Una pregunta sobre tests de personalidad es más fácil que encontrar la fuente de un fragmento de noticia, así que el porcentaje de error probablemente sea menor. El patrón que importa sigue valiendo. Una frase segura con un enlace debajo no significa que el enlace diga lo que dice la frase. InsightWonder recoge una definición clara de alucinación en este sentido exacto, también en inglés, y merece la pena leerla una vez.
El test de las 16 personalidades no es el MBTI
En español, como en muchos otros idiomas, «el test de las 16 personalidades» y «el MBTI» se usan casi como sinónimos. Para mucha gente, hacer el MBTI significa hacer el cuestionario gratuito de 16Personalities. Las cuatro letras se parecen. El instrumento no es el mismo.
La propia 16Personalities lo explica en su página de teoría. Toma el formato de siglas del Myers-Briggs por su sencillez y comodidad, no incorpora conceptos de Jung como las funciones cognitivas porque, según la misma web, son muy difíciles de medir y validar científicamente, y su modelo reelabora y reequilibra las dimensiones de los cinco grandes. Por eso añade una quinta letra, la A o la T, que describe la confianza y la sensibilidad al estrés y que no existe en el MBTI oficial.
Esto importa al preguntarle a un chatbot si el MBTI es fiable. Un modelo puede mezclar en la misma respuesta las críticas académicas al MBTI oficial y las opiniones de usuarios sobre el test de las 16 personalidades. Las primeras hablan de fiabilidad y validez; las segundas, sobre todo de si el resultado encajó con quien lo hizo. Una respuesta que las junta no describe bien a ninguno de los dos.
La comprobación es sencilla. Basta con preguntar al asistente si, cuando habla del MBTI, se refiere al instrumento oficial o al test de 16Personalities. Si es capaz de separarlos y corregirse, su respuesta merece cierta confianza. Si no, está construida sobre una confusión.
Por qué unos tests y unas webs aparecen y otros no
Si la respuesta depende de qué páginas se recuperaron y de lo fácil que era citarlas, también se pueden escribir páginas pensadas para ser recuperadas y citadas. Hoy esto es un campo con nombre propio, la optimización para motores generativos, abreviada como GEO, y con su propia investigación.
El artículo que dio nombre al campo lo firmaron investigadores de Princeton, Georgia Tech, el Allen Institute for AI y el IIT de Delhi, y se presentó en KDD 2024. Su resultado central fue que cambiar la forma de escribir una página, por ejemplo añadiendo estadísticas, citas textuales y referencias, podía aumentar su visibilidad dentro de las respuestas generativas hasta en un 40%. Los cambios no alteraban lo que era cierto. Alteraban lo citable que resultaba.
Para quien quiere saber en qué test confiar, ese hallazgo corta en dos direcciones. Es tranquilizador que se favorezca la escritura cuidadosa y con fuentes. Lo es menos que las mismas técnicas estén al alcance de cualquiera, incluida una empresa de tests con motivos comerciales para aparecer la primera.
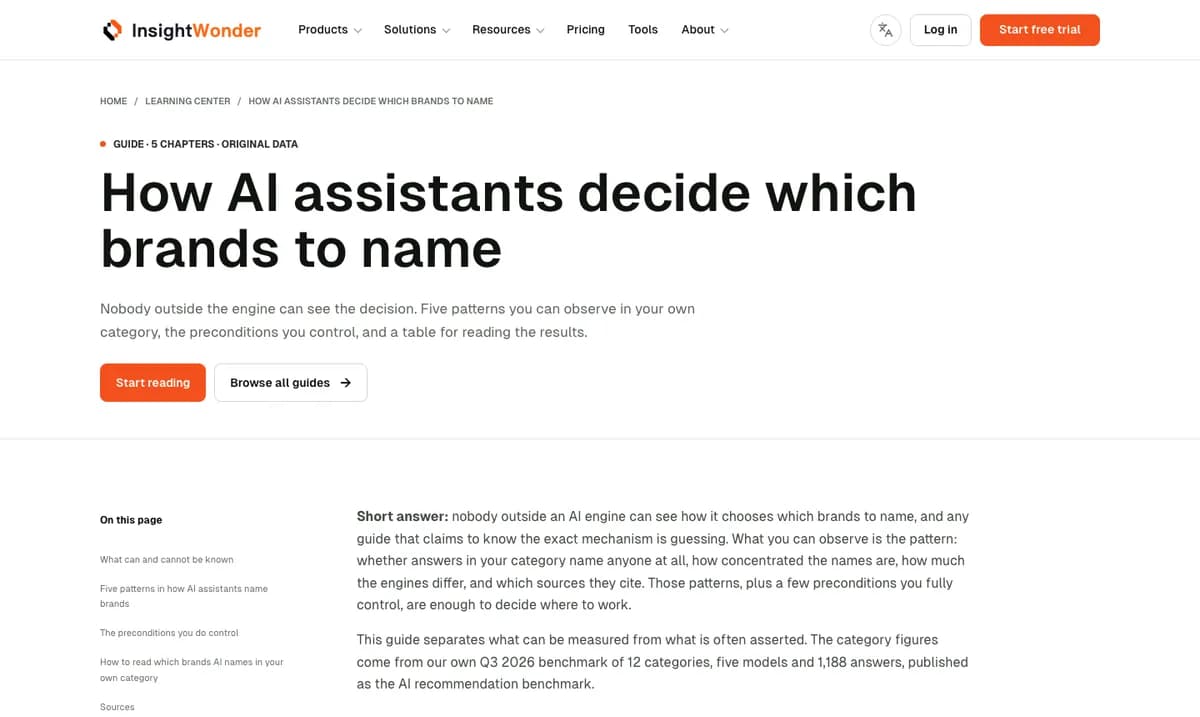
La guía de InsightWonder, en inglés, sobre cómo deciden los asistentes de IA qué marcas nombrar empieza admitiendo algo que casi todo lo que se escribe sobre el tema evita: desde fuera de un motor nadie puede ver la decisión. Lo que sí se puede observar es el patrón a lo largo de muchas respuestas, qué nombres se repiten, cuánto se concentran y qué fuentes se citan. Ese es el marco honesto para leer cualquier respuesta suelta, también la que habla de tests de personalidad. Es una extracción de una distribución, no un veredicto.
De dónde vienen las fuentes de estas respuestas
Al abrir los enlaces que aparecen bajo una respuesta de IA sobre tests de personalidad, suelen caer en cuatro tipos, y cada uno se inclina hacia su propio lado.
El primero es la empresa que ofrece el test. Una web que vende o aloja un test tiene todos los motivos para explicar por qué su modelo es el correcto, y estas páginas suelen ser las más claras y citables sobre el tema, porque están escritas para convencer. No son falsas por defecto. Son parte interesada, y un ranking construido sobre todo con ellas hereda ese interés.
El segundo es la página de referencia general, una entrada de enciclopedia o un artículo divulgativo amplio. Suelen ser equilibradas y suelen ir unos años por detrás. Pueden describir una versión de un test que ya se sustituyó o resumir un debate que ya avanzó.
El tercero es el foro. Los hilos donde la gente compara resultados son vivos y sinceros sobre la experiencia, y una mala guía sobre la medición. Un foro puede decir que a mucha gente un test le pareció acertado; no puede decir si lo es.
El cuarto es la fuente de investigación, un artículo científico o una página universitaria, y es el menos frecuente en las respuestas informales porque es el más difícil de citar. Sus conclusiones llegan matizadas, enterradas en la metodología y expresadas como tamaños de efecto y no como veredictos. Una respuesta que cita al menos una fuente de este cuarto tipo merece bastante más confianza que una que no cita ninguna.
La guía de InsightWonder sobre análisis de citas, en inglés, describe cómo leer de forma sistemática las fuentes de una respuesta, y casi todo sirve fuera del marketing. La versión corta es preguntarse, ante cada enlace, quién lo escribió y qué gana si se le cree.
En español hay un matiz más. Muchas respuestas en castellano se apoyan en investigación y divulgación escritas en inglés, y algunas en traducciones automáticas de páginas comerciales. No es malo por sí mismo, pero solo abriendo la fuente se sabe si lo que se cita sobre el MBTI se refiere al instrumento oficial o al test de las 16 personalidades.
Qué debería significar que un test sea preciso
Antes de juzgar si una respuesta de IA acierta, ayuda saber cómo sería acertar. La precisión de un test de personalidad no es una sola propiedad. La psicología la divide al menos en tres.
La fiabilidad es si el test da el mismo resultado dos veces. Un cuestionario que coloca a la misma persona en categorías distintas con pocas semanas de diferencia está midiendo algo inestable, o lo está midiendo mal. La validez es si las puntuaciones reflejan lo que dicen medir, que es la pregunta más difícil y el tema de la entrada sobre validez de constructo. Y la utilidad es si el resultado predice algo que ocurre fuera del test, como las notas, la salud, las relaciones o cómo sale un trabajo.
En este tercer punto, la evidencia a favor de los cinco grandes es especialmente sólida. En 2019, Christopher Soto replicó con registro previo 78 relaciones ya publicadas entre los cinco grandes rasgos y distintos resultados vitales, con una muestra mediana de 1.504 personas por réplica. El 87% de los intentos fue estadísticamente significativo en la dirección esperada, aunque los efectos solían ser unas tres cuartas partes de los originales. Para un campo que pasó por una crisis de replicación, es un buen historial.
Esto es, más o menos, lo que dirá una buena respuesta de IA, y en esta cuestión el consenso que refleja es auténtico. La guía de los cinco grandes explica los cinco rasgos con más detalle, y el test de los cinco grandes indica dónde se sitúa cada persona en cada uno como percentil y no como tipo. El test de estilo MBTI también está disponible, y conviene hacerlo con esa comparación en mente: es un buen punto de partida para conversar y una medición más débil.
Lo que una respuesta de IA acierta mucho menos es el paso siguiente: qué test gratuito concreto mide bien los cinco grandes. Eso depende de detalles que un chatbot casi nunca ve, como cuántos ítems tiene el test, si da percentiles respecto a una muestra de referencia declarada y si el resultado gratuito es el resultado completo. La comparativa de tests de personalidad gratuitos de esta web revisa esos detalles test por test e incluye el propio test de la web con sus puntos débiles.
Lo que las respuestas de IA suelen dejar pasar
En la comparación de fondo, modelos de rasgos frente a modelos de tipos, las respuestas de IA tienden a ser sensatas, porque la literatura publicada está muy inclinada hacia un lado y los modelos la han absorbido. Son menos fiables con los marcos que están entre la medición seria y el entretenimiento, y ese terreno intermedio es donde la mayoría de los lectores pasa de verdad su tiempo.
El eneagrama es el ejemplo más claro. Es un vocabulario rico para hablar de motivaciones y tiene una literatura propia muy entregada, pero como medición su respaldo es escaso frente a los cinco grandes, y no se ha demostrado que sus nueve tipos dividan a las personas por fronteras naturales. Algunas respuestas de IA lo dicen sin rodeos. Otras describen los nueve tipos con la misma seguridad que darían a un rasgo validado, porque las páginas más citables sobre el eneagrama las escriben quienes lo practican. La guía de los tipos del eneagrama de esta web no pierde de vista esa limitación, y la entrada que compara marcos tipológicos explica dónde queda cada familia de modelos.
La astrología es el caso contrario, y las respuestas de IA suelen manejarla bien. Cuando el físico Shawn Carlson publicó en Nature en 1985 un experimento de doble ciego, los astrólogos no lograron emparejar cartas natales con perfiles de personalidad mejor que el azar, un resultado tan limpio como pocos en la investigación sobre personalidad. Un chatbot que recomienda el horóscopo como test de personalidad ha fallado una pregunta con una respuesta inusualmente clara.
Conviene recordar el patrón. Donde la evidencia es abrumadora en un sentido u otro, las respuestas de IA tienden a seguirla. Donde la evidencia es mixta y los textos más entusiastas los firman quienes practican el método, las respuestas de IA tienden a seguir el entusiasmo.
Cómo comprobar la respuesta en cinco minutos
Comprobar una respuesta de IA lleva unos cinco minutos y no exige saber psicología. Sí exige abrir los enlaces en lugar de quedarse con el resumen.
| Lo que dice la respuesta | Qué comprobar | Qué es una buena señal |
|---|---|---|
| Los cinco grandes son el modelo más científico | Si la fuente es una revista, una universidad o una empresa de tests | Al menos una fuente que no venda tests |
| El test X es el gratuito más preciso | Cuántas preguntas tiene y si da percentiles | 40 ítems o más y percentiles sobre una muestra nombrada |
| El MBTI no es fiable | Si la fuente explica por qué o solo lo afirma | Un motivo concreto, como letras que cambian cerca del centro |
| Aquí tienes tres tests gratuitos | Si una de esas webs es también la fuente principal | El ranking no copia la lista de una sola empresa |
| Por tu tipo deberías | Si un resultado se estira hasta convertirse en receta | Una advertencia sobre usar tests para contratar o diagnosticar |
Dos hábitos marcan casi toda la diferencia. El primero es hacer la misma pregunta en un segundo motor, o dos veces en el mismo, y comparar. Las respuestas basadas en recuperación varían, y un test que aparece siempre es una señal más fuerte que uno que aparece una vez. El segundo es preguntar directamente al asistente qué fuentes usó y por qué. Un buen asistente las enumera; una respuesta vaga ya es información.
Hay una comprobación más que se olvida con facilidad: la fecha. Los tests se revisan, las versiones gratuitas se acortan y una página que describe un test tal como era hace cinco años puede seguir siendo la que recupera un chatbot. Buscar la fecha en cada página citada lleva segundos, y la guía de InsightWonder sobre frescura del contenido y fechas, en inglés, explica qué señales de fecha ve de verdad una máquina, que no siempre coinciden con la fecha que ve primero una persona.
Para quien prefiera ver el paso oculto en lugar de deducirlo, la herramienta gratuita AI Visibility Snapshot de InsightWonder lanza a un motor de IA real unas cuantas preguntas sobre una web y muestra qué nombres aparecen y qué páginas se citan. No pide cuenta y está en inglés. La propia herramienta aclara que cada prueba es una muestra única de cinco preguntas a un solo modelo y no una medición de mercado, que es exactamente como debería leerse cualquier respuesta suelta de un chatbot.
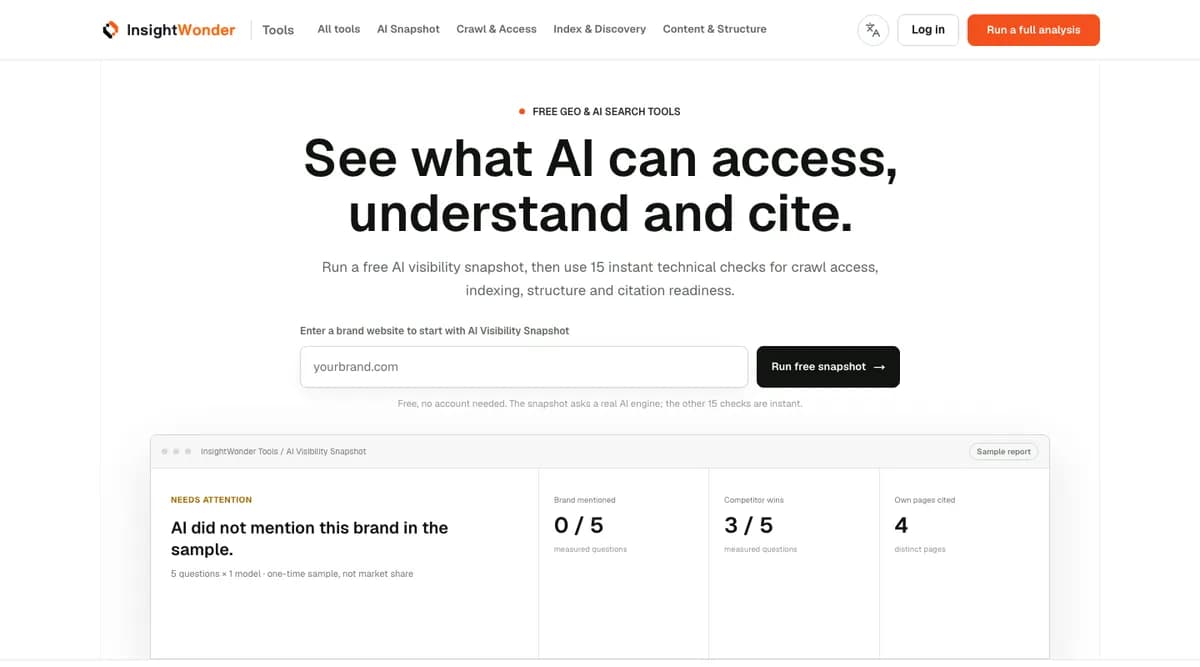
Probarla con algunas webs de tests de personalidad es instructivo. El mismo puñado de dominios tiende a citarse una y otra vez, y no siempre son los que tienen la evidencia más sólida. Son los que tienen las páginas más fáciles de citar.
Cuando le pides a una IA que interprete un resultado
Cada vez más gente hace lo contrario de preguntar qué test hacer. Hace un test, pega el resultado en un chatbot y pregunta qué significa. Es un uso más razonable de la herramienta, y tiene su propio fallo.
Lo razonable es que un modelo de lenguaje explica bien las definiciones. Si se le pregunta cómo suelen verse juntas en el trabajo una responsabilidad alta y una amabilidad baja, la respuesta casi siempre será sensata, porque la investigación sobre combinaciones de rasgos es amplia y está bien representada en los datos de entrenamiento. Explicar un rasgo es donde un chatbot más se parece a un buen manual.
El fallo es la generosidad. Los chatbots están ajustados para ser amables, y una interpretación escrita para un lector concreto tiende a lo halagador y a lo que vale para casi todo el mundo. Es la forma exacta del efecto Barnum: la gente valora como muy precisas descripciones vagas que encajarían con casi cualquiera cuando cree que están escritas para ella. Un resultado interpretado con calidez por un chatbot puede parecer más preciso de lo que son el test o el propio chatbot.
La corrección es sencilla. Hay que pedir al mismo asistente que describa cómo sería la puntuación contraria y que diga qué partes de su interpretación valdrían para la mayoría de la gente. Lo que sobrevive a esa pregunta es lo que merece la pena guardar.
La misma precaución vale para la asistente de esta web. Luna lee los resultados que alguien ha obtenido aquí, lo que hace sus respuestas más concretas que las de un chatbot general, y aun así es un modelo de lenguaje que escribe una interpretación, no una medición.
Por qué la respuesta suena más segura que la evidencia
Parte de lo que hace convincentes las respuestas de IA es que toman el tono de la experiencia sin sus matices. Una psicóloga a la que se le pregunta qué test es el más preciso suele responder con otra pregunta: ¿preciso para qué? Para una tarde de dinámicas de equipo, un modelo de tipos sirve. Para investigar, o para cualquier cosa con consecuencias, una medida de rasgos validada es la opción defendible, e incluso así una sola aplicación es una instantánea.
El chatbot tiende a comprimir todo eso en un ranking. El ranking no es tanto falso como respuesta a una pregunta más simple que la que se hizo. Y un ranking halaga al lector de una manera concreta: sugiere que, una vez encontrado el test correcto, el resultado puede tomarse al pie de la letra.
Todos los tests de personalidad, también los buenos, piden a la gente que se describa a sí misma. La entrada sobre cuestionarios de autoinforme explica lo que eso introduce: cómo se ve cada persona, que en algunos rasgos se acerca a la verdad y en otros bastante menos. Ningún ranking de tests elimina ese límite. Solo dice qué instrumentos lo manejan mejor.
Qué cambia en la próxima respuesta
La conclusión práctica es modesta y útil. Una respuesta de IA es un lugar razonable para empezar una pregunta sobre tests de personalidad y un mal lugar para terminarla. En la cuestión general de rasgos frente a tipos suele reflejar un consenso real. En la cuestión concreta de qué test gratuito hacer y cuánto fiarse, refleja las páginas que le tocó recuperar ese día.
Lo que merece la pena mirar son las fuentes de la respuesta. También son, cada vez más, la parte que se está moldeando, tanto por investigadores que estudian el efecto como por empresas que quieren ser nombradas. Saberlo basta para leer la próxima respuesta de otra manera.
Un resultado de test merece el mismo trato. La entrada sobre tests gratuitos y evaluaciones formales explica qué puede y qué no puede decir un cuestionario gratuito en línea, y vale para todos los tests de esta web tanto como para los de cualquier otra.
Sources
- Instituto Nacional de Estadística (2025). Encuesta sobre Equipamiento y Uso de Tecnologías de Información y Comunicación en los Hogares, año 2025.
- Pew Research Center (2025). Google users are less likely to click on links when an AI summary appears in the results.
- Jaźwińska, K., Chandrasekar, A. (2025). AI search has a citation problem. Columbia Journalism Review, Tow Center for Digital Journalism.
- 16Personalities. Our theory.
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., Deshpande, A. (2024). GEO: generative engine optimization. Proceedings of KDD 2024.
- Soto, C. J. (2019). How replicable are links between personality traits and consequential life outcomes? The Life Outcomes of Personality Replication Project. Psychological Science, 30(5).
- Carlson, S. (1985). A double-blind test of astrology. Nature, 318.